Dans la partie précédente, nous avons vu la théorie avec la loi de Little. Cette fois, nous passons à la pratique : on charge une vraie application et on vérifie que les chiffres collent.
Notre banc de test :
- une application Spring Boot / JPA ;
- k6 pour générer la charge ;
- Prometheus pour collecter les métriques, et Grafana pour les afficher.
Petit rappel de la loi de Little :
L = λ × W
- L : la concurrence, c’est-à-dire le nombre de requêtes en cours à un instant donné
- λ : le débit, en requêtes par seconde (req/s)
- W : la latence
Avec deux valeurs, on trouve la troisième :
- débit + latence → concurrence, donc taille de pool nécessaire :
L = λ × W - taille du pool + débit → latence maximale :
W = L / λ - taille du pool + latence → débit maximal :
λ = L / W
Comme dans la partie 1, on note x le temps pendant lequel une requête occupe une connexion Hikari.
Les métriques Link to heading
Spring Boot Actuator expose les métriques sur l’endpoint /actuator/prometheus.
Côté HTTP / Tomcat Link to heading
Deux propriétés sont nécessaires :
# expose les métriques des threads Tomcat
server.tomcat.mbeanregistry.enabled=true
# expose l'histogramme des latences, pour calculer p50 et p95
management.metrics.distribution.percentiles-histogram.http.server.requests=true
| Métrique Prometheus | Type | Ce qu’elle mesure | Terme de Little |
|---|---|---|---|
http_server_requests_seconds_count{uri,status} | counter | nombre de requêtes terminées | → λ |
http_server_requests_seconds_sum{uri,status} | counter | somme des latences (s) | → λ × W |
http_server_requests_seconds_bucket{le} | histogram | répartition des latences | → W (p50, p95) |
tomcat_threads_busy_threads | gauge | threads en train de traiter une requête | L Tomcat mesuré |
tomcat_threads_config_max_threads | gauge | server.tomcat.threads.max | plafond de L |
Côté HikariCP Link to heading
Ces métriques sont disponibles dès qu’Actuator est présent. Rien à configurer.
| Métrique Prometheus | Type | Ce qu’elle mesure | Terme de Little |
|---|---|---|---|
hikaricp_connections_active{pool} | gauge | connexions actuellement prêtées | L Hikari mesuré |
hikaricp_connections_pending{pool} | gauge | threads qui attendent une connexion | la file d’attente |
hikaricp_connections_max{pool} | gauge | maximum-pool-size | plafond de L |
hikaricp_connections_usage_seconds_sum / _count | counter | durée d’utilisation d’une connexion (de getConnection au close) | → x |
hikaricp_connections_acquire_seconds_sum / _count | counter | temps pour obtenir une connexion du pool | attente dans la file |
hikaricp_connections_timeout_total | counter | échecs après connection-timeout | effondrement |
Les requêtes PromQL Link to heading
Toutes les fenêtres sont de 10 secondes ([10s]). Prometheus doit donc collecter les métriques au moins toutes les 5 secondes. Sinon, rate() ne renvoie rien.
λ, le débit Link to heading
Le nombre de requêtes HTTP traitées par seconde :
sum(rate(http_server_requests_seconds_count{uri="/work"}[10s]))
W, la latence Link to heading
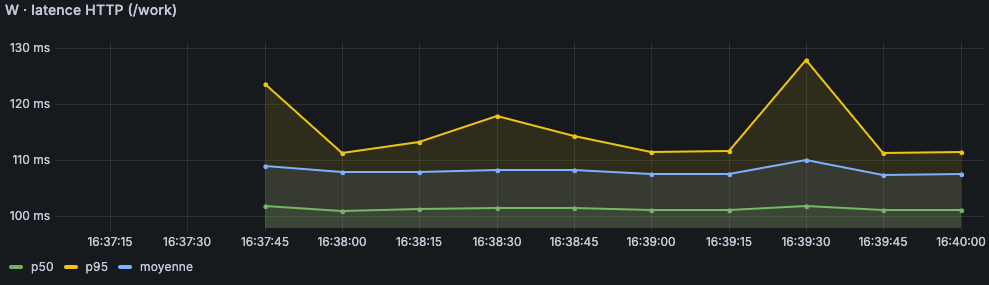
La latence totale d’une requête HTTP. On divise la somme des latences par le nombre de requêtes :
sum(rate(http_server_requests_seconds_sum{uri="/work"}[10s]))
  / sum(rate(http_server_requests_seconds_count{uri="/work"}[10s]))
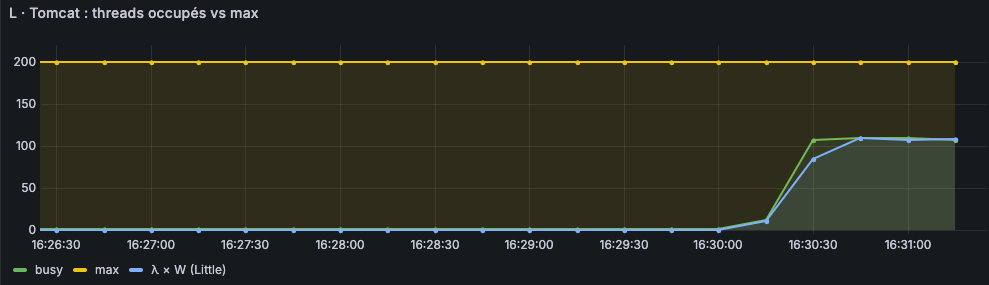
L Tomcat : mesuré vs calculé Link to heading
On compare deux valeurs :
- le nombre de threads occupés, mesuré par Tomcat ;
- le produit λ × W, calculé avec la loi de Little.
tomcat_threads_busy_threads                                      # mesuré
sum(rate(http_server_requests_seconds_sum{uri="/work"}[10s]))    # λ × W
Pourquoi la seconde requête donne λ × W ? rate(..._sum) donne la somme des latences par seconde. C’est exactement le débit multiplié par la latence moyenne.
Si la loi de Little est respectée, les deux courbes se superposent.
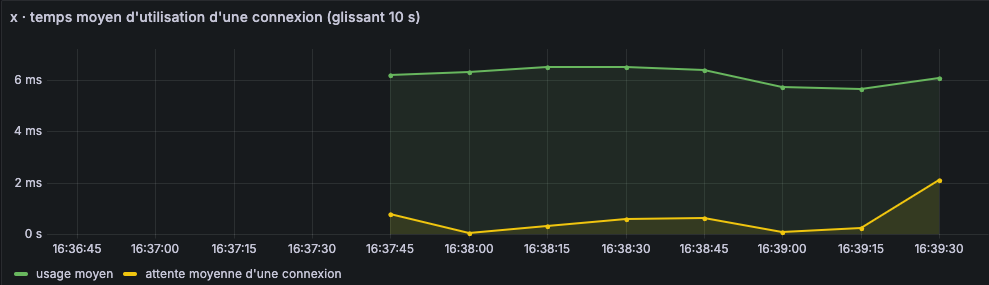
x, le temps d’occupation d’une connexion Link to heading
rate(hikaricp_connections_usage_seconds_sum[10s])
  / rate(hikaricp_connections_usage_seconds_count[10s])
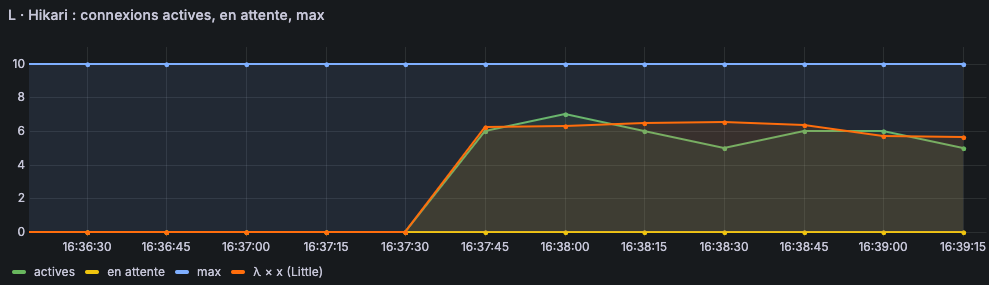
L Hikari : mesuré vs calculé Link to heading
Même principe que pour Tomcat :
hikaricp_connections_active                                      # mesuré
rate(hikaricp_connections_usage_seconds_sum[10s])                # λ × x
Capacité maximale et marge Link to heading
On combine les métriques précédentes pour connaître le débit maximal de chaque pool. C’est la formule λ_max = L / W, avec L égal à la taille du pool.
# λ_max Hikari = taille du pool / x
hikaricp_connections_max
  / (rate(hikaricp_connections_usage_seconds_sum[10s]) / rate(hikaricp_connections_usage_seconds_count[10s]))

# λ_max Tomcat = nombre de threads / W
tomcat_threads_config_max_threads
  / (sum(rate(http_server_requests_seconds_sum{uri="/work"}[10s])) / sum(rate(http_server_requests_seconds_count{uri="/work"}[10s])))
On prend ensuite le minimum des deux. Le débit d’un système est borné par sa ressource la plus contrainte.
L’écart entre ce λ_max et le débit réel, c’est notre marge.
On peut aussi suivre le taux d’utilisation de chaque pool. À 100 %, une file d’attente se forme.
hikaricp_connections_active / hikaricp_connections_max
tomcat_threads_busy_threads / tomcat_threads_config_max_threads
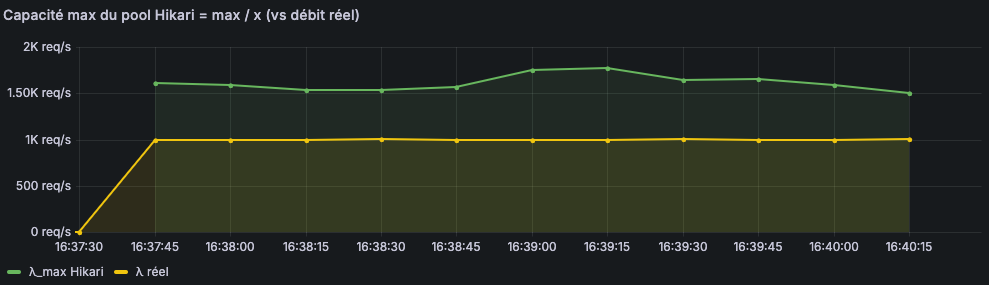
Illustration : un système non saturé Link to heading
On lance le test avec la commande suivante :
k6 run -e RATE=1000 -e DB=5 -e APP=100 k6/load.js
- λ = 1 000 req/s
- x (temps SQL) = 5 ms
- W (temps total) = 100 ms
On garde les valeurs par défaut de Spring Boot :
server.tomcat.threads.max=200
spring.datasource.hikari.maximum-pool-size=10
Calcul théorique Link to heading
Côté Hikari :
L = 1 000 × 0,005 = 5
5 connexions sur 10 sont utilisées en permanence.
Côté Tomcat :
L = 1 000 × 0,1 = 100
100 threads sur 200 sont occupés en permanence.
Ce que montrent les métriques Link to heading
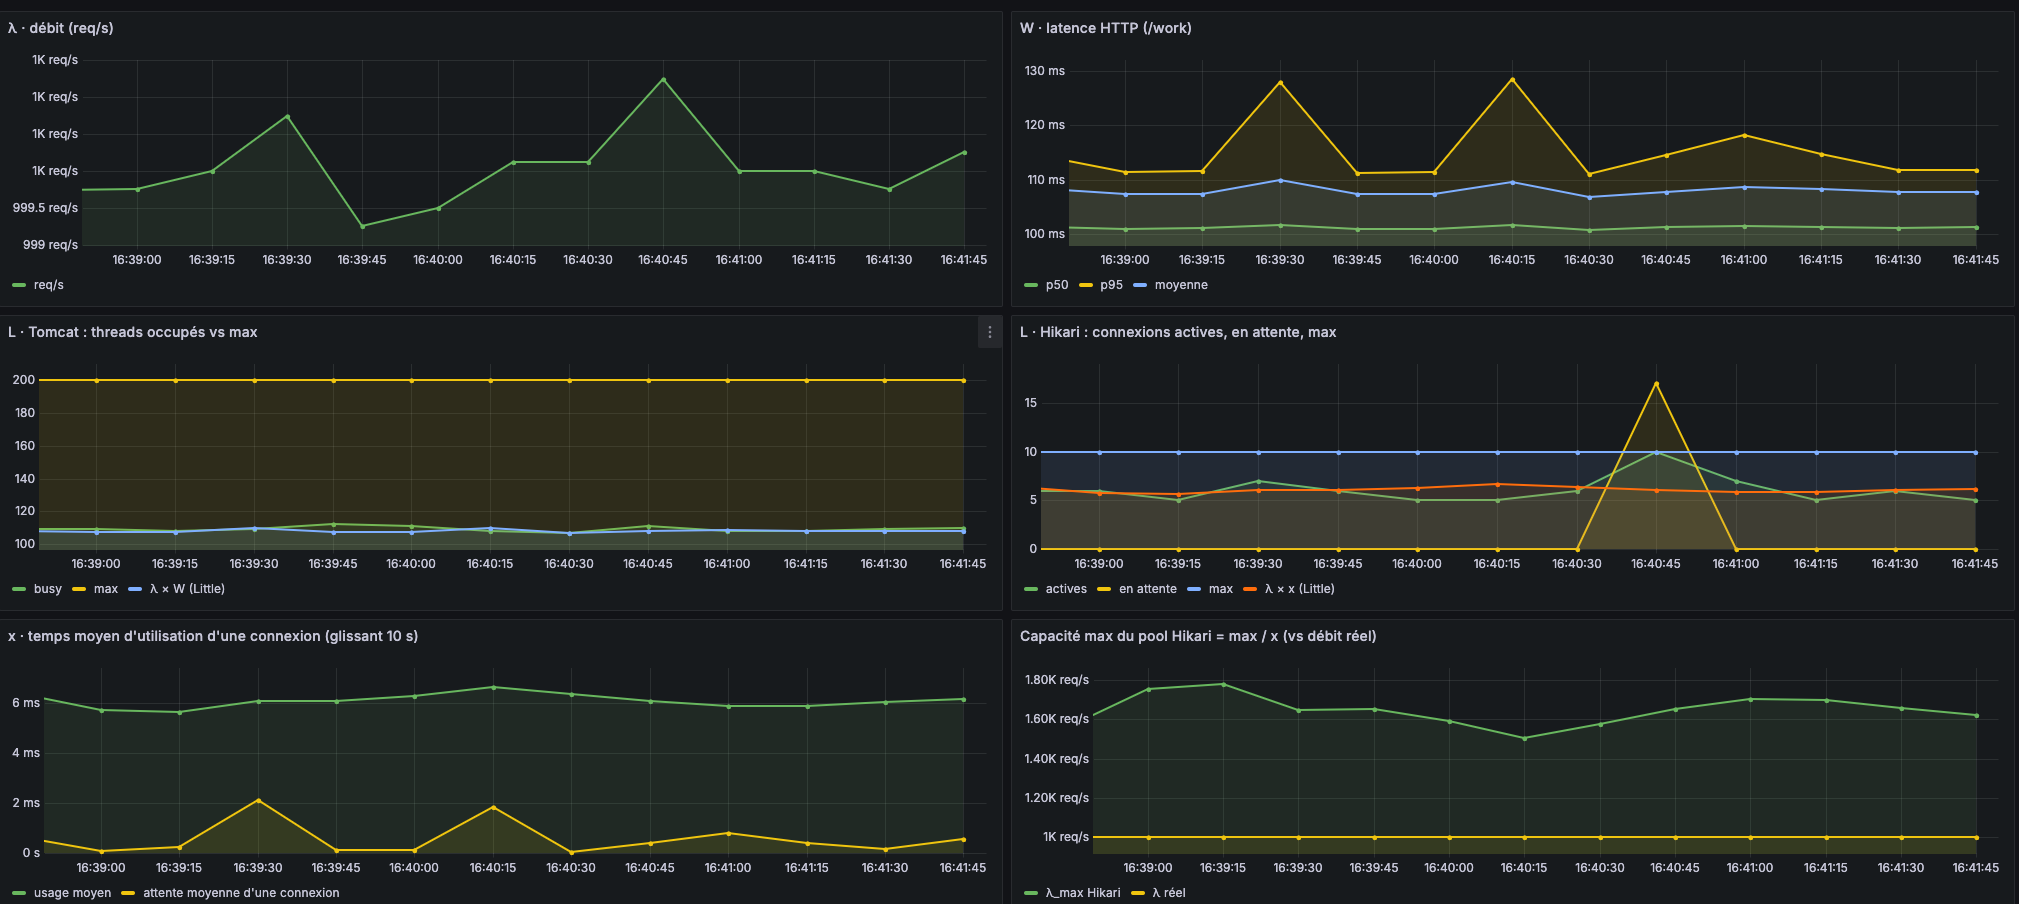
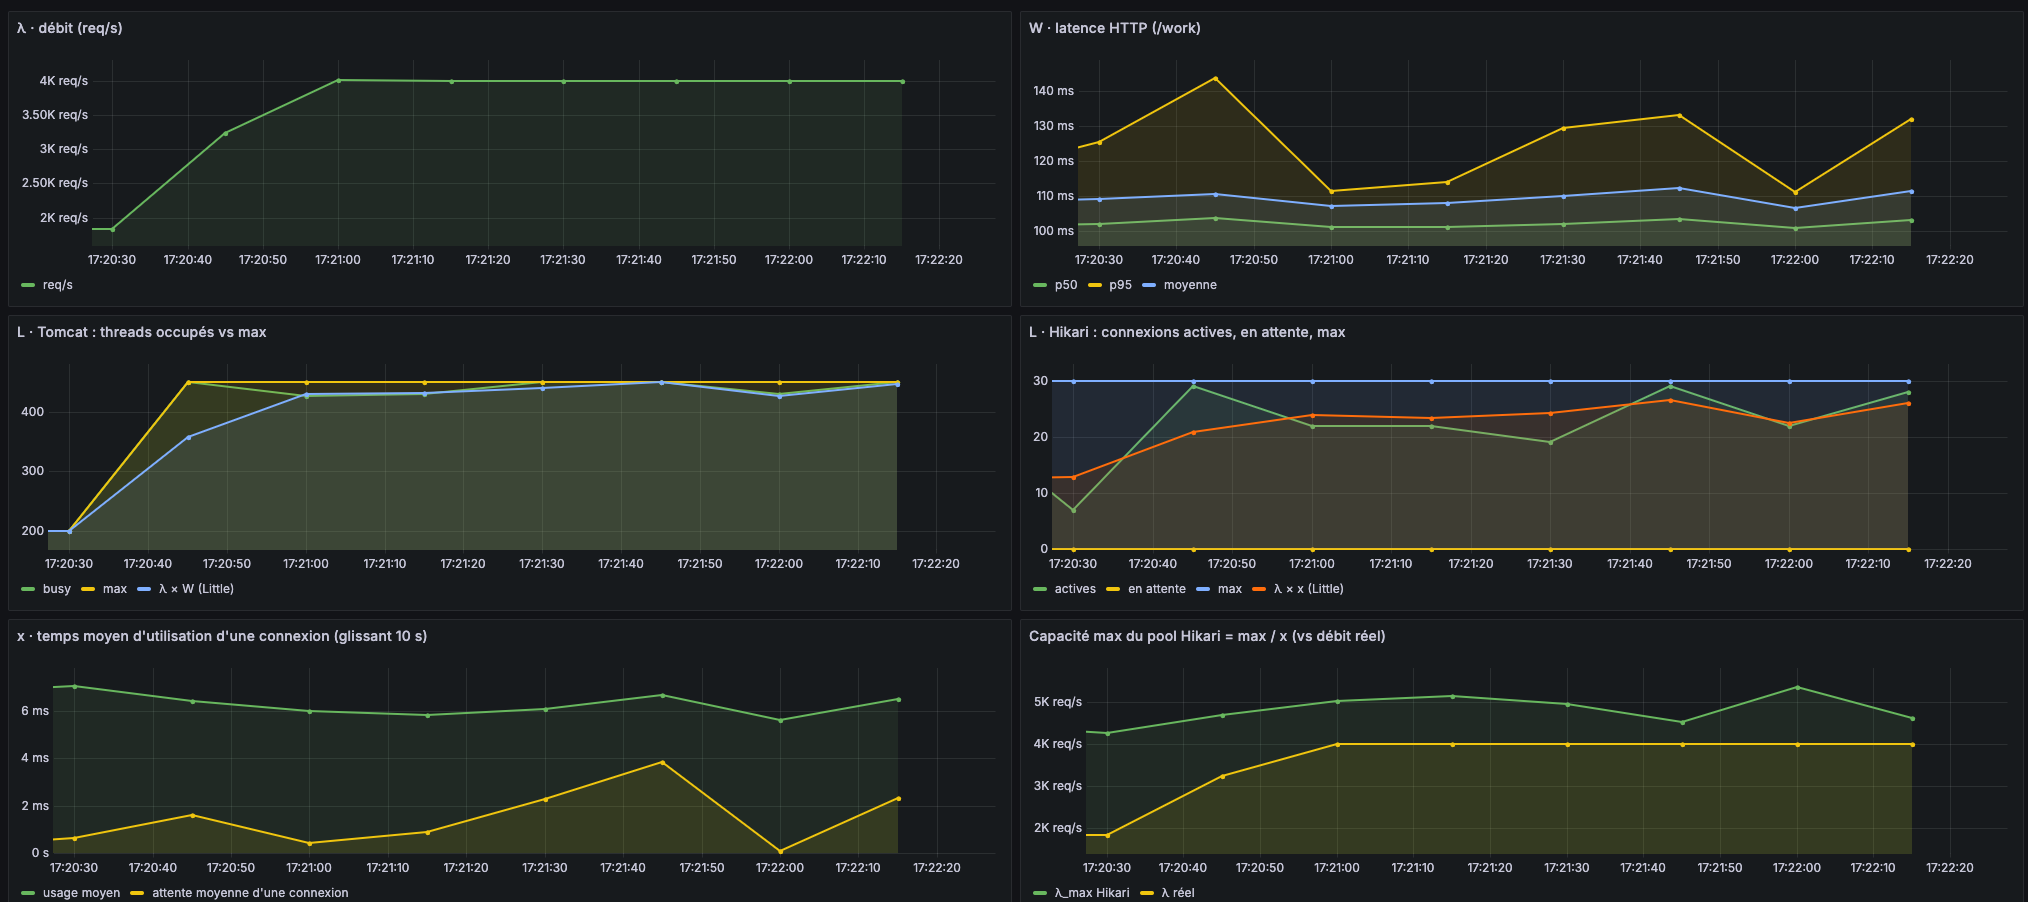
On retrouve nos chiffres, avec un léger surcoût :
| Grandeur | Théorie | Mesure |
|---|---|---|
| λ | 1 000 req/s | ≈ 1 000 req/s |
| W | 100 ms | ≈ 108 ms |
| L Tomcat | 100 | ≈ 108 |
| x | 5 ms | ≈ 6 ms |
| L Hikari | 5 | ≈ 6 |
Les valeurs mesurées sont un peu plus hautes. C’est normal : le framework ajoute son propre temps (filtres Spring, transaction, sérialisation, emprunt de la connexion…).
Surtout, les courbes « mesuré » et théorique (λ × W) se superposent. La loi de Little se vérifie en conditions réelles.
La capacité maximale du pool Hikari Link to heading
Le dernier graphique affiche entre 1 500 et 1 750 req/s. D’où vient ce chiffre ?
En théorie, avec x = 5 ms :
λ_max = 10 / 0,005 = 2 000 req/s
Mais en réalité, une connexion est occupée environ 6 ms, avec des pointes à 6,6 ms. Le débit maximal réel est donc plus bas :
λ_max = 10 / 0,0066 ≈ 1 500 req/s
1,6 ms de plus par requête SQL, et le pool perd un quart de sa capacité.
Côté Tomcat, avec W ≈ 108 ms :
λ_max = 200 / 0,108 ≈ 1 850 req/s
On applique la loi du goulot d’étranglement :
λ_max = min(1 850, 1 500) = 1 500 req/s
Conclusion Link to heading
Avec 1 000 req/s le système tient. Il a environ 50 % de marge. Et si la charge augmente, c’est Hikari qui lâchera en premier.
Illustration : un système saturé Link to heading
Le nombre de clients augmente. On passe de 1 000 req/s à 4 000 req/s. Côté application, rien ne change :
- une requête SQL dure toujours 5 ms ;
- une requête HTTP dure toujours 100 ms.
La configuration reste identique :
server.tomcat.threads.max=200
spring.datasource.hikari.maximum-pool-size=10
On lance le test :
k6 run -e RATE=4000 -e DB=5 -e APP=100 k6/load.js
La prédiction Link to heading
On a calculé plus haut que le système plafonne à environ 1 500 req/s. On lui en demande 4 000. Il va donc saturer, et c’est Hikari qui doit céder en premier.
Ce que montrent les métriques Link to heading
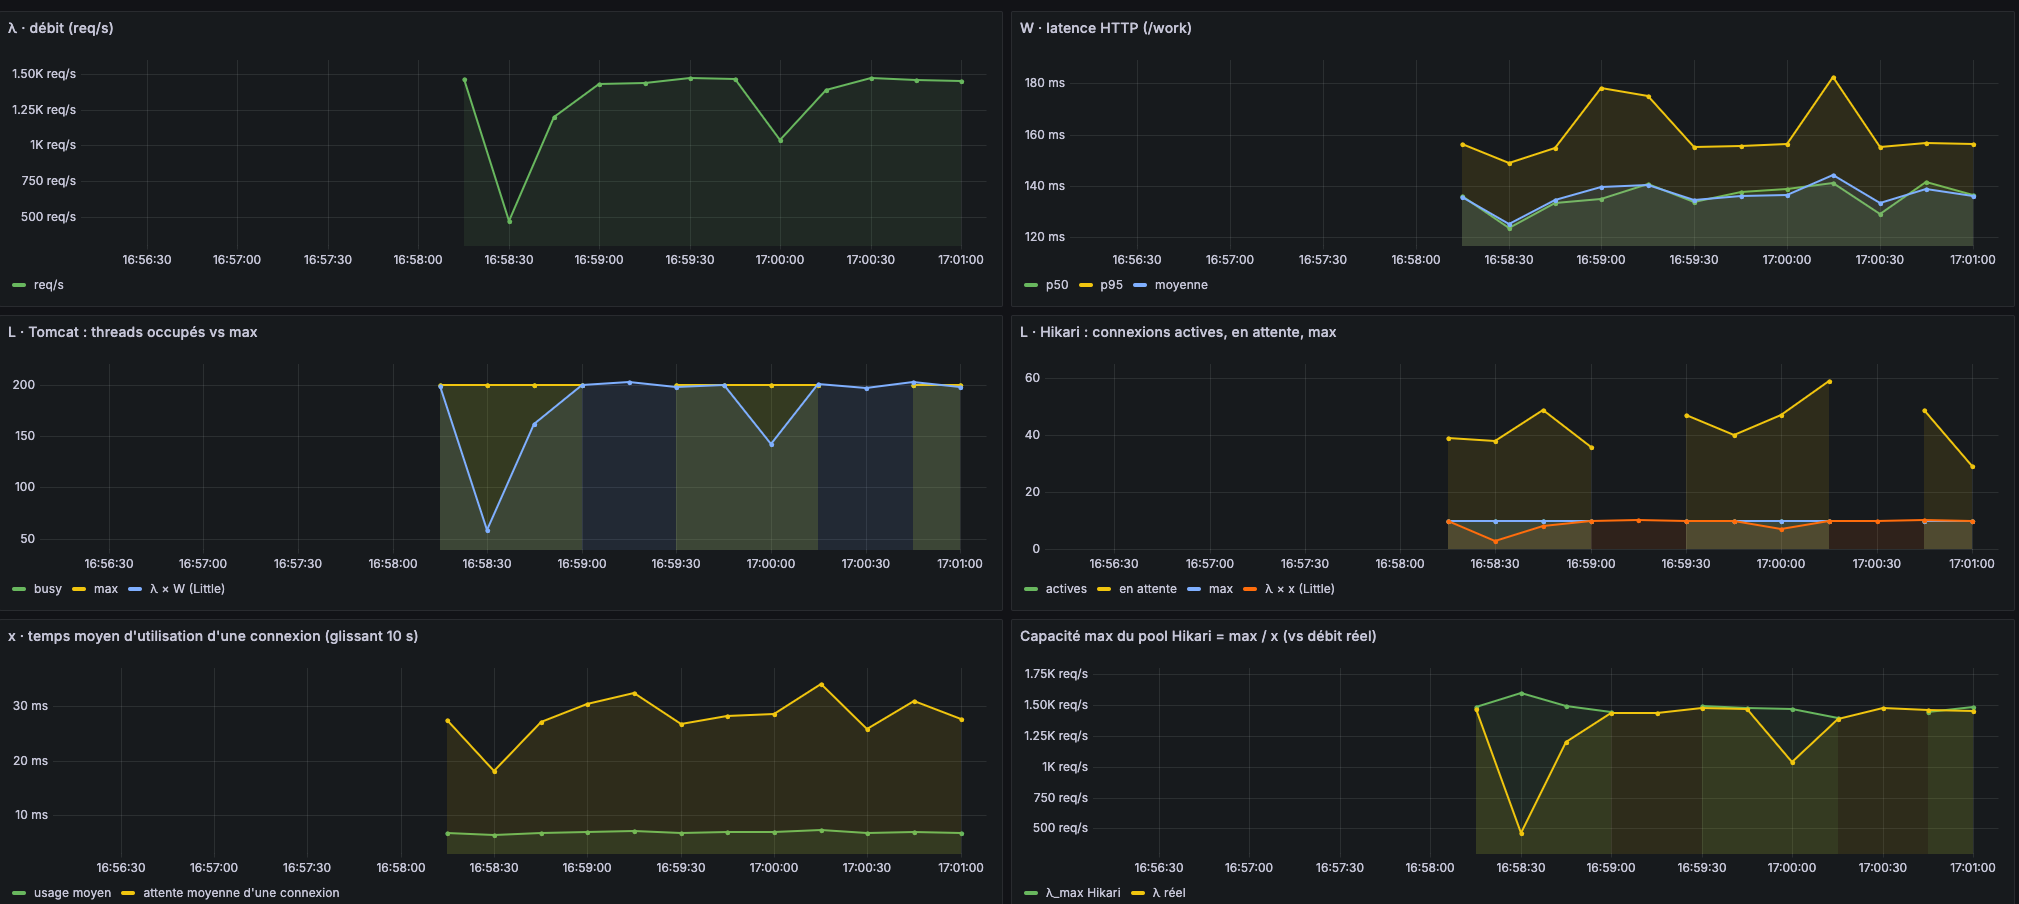
| Grandeur | À 1 000 req/s | À 4 000 req/s demandées |
|---|---|---|
| λ réel | ≈ 1 000 req/s | ≈ 1 450 req/s |
| W (moyenne) | ≈ 108 ms | ≈ 137 ms |
| W (p95) | ≈ 112 ms | ≈ 160 ms |
| Threads Tomcat occupés | ≈ 108 / 200 | 200 / 200 |
| Connexions Hikari actives | ≈ 6 / 10 | 10 / 10 |
| Connexions en attente | 0 | 30 à 60 |
| x (usage d’une connexion) | ≈ 6 ms | ≈ 6 ms |
| Attente d’une connexion | < 1 ms | ≈ 28 ms |
Le débit plafonne Link to heading
On demande 4 000 req/s, mais l’application n’en traite que 1 450 environ. C’est la limite calculée avec la loi du goulot d’étranglement.
Le dernier graphique le montre bien : la courbe du débit réel colle à celle de λ_max Hikari. Le pool travaille à pleine capacité.
Les 2 500 autres requêtes par seconde n’entrent même pas dans l’application. Elles attendent en amont.
Hikari est saturé Link to heading
Les 10 connexions sont prises en permanence. Entre 30 et 60 threads attendent une connexion.
Le temps SQL, lui, n’a presque pas bougé : environ 7 ms. La base de données n’est pas en cause. C’est le pool qui est trop petit pour ce débit.
On peut même appliquer la loi de Little à la file d’attente :
L = 1 450 × 0,028 ≈ 40 threads en attente
C’est bien ce que l’on observe.
Tomcat est saturé, mais ce n’est qu’un symptôme Link to heading
Les 200 threads Tomcat sont occupés. Pourtant, Tomcat n’est pas la cause.
Comme on l’a vu dans la partie 1, un thread qui attend une connexion Hikari garde son thread Tomcat. Chaque requête attend environ 28 ms une connexion. Ce temps s’ajoute à la latence :
W ≈ 108 ms + 28 ms ≈ 136 ms
On le vérifie avec la loi de Little, côté Tomcat :
W = L / λ = 200 / 1 450 ≈ 0,138 s
La latence mesurée est de 137 ms. Les chiffres concordent.
Augmenter les ressources Link to heading
Conclusion Link to heading
Quand la charge dépasse la capacité :
- le débit ne suit pas, il plafonne à λ_max ;
- la latence augmente, à cause du temps d’attente ;
- tous les pools sont pleins, même ceux qui ne sont pas responsables.
Regarder Tomcat seul pourrait faire croire qu’il manque des threads. Mais ajouter des threads ne servirait à rien : ils attendraient eux aussi une connexion. Ce sont hikaricp_connections_pending et le temps d’attente d’une connexion qui désignent le vrai coupable.
Pour tenir 4 000 req/s, il faudrait au minimum :
L = 4 000 × 0,007 = 28 connexions
Et côté Tomcat, 4 000 × 0,108 ≈ 430 threads.
Correction d’un système saturé Link to heading
La mauvaise correction Link to heading
Supposons qu’on se trompe de coupable. On voit 200 threads Tomcat occupés sur 200, et on en conclut qu’il manque des threads.
On calcule alors la taille nécessaire avec la loi de Little, en reprenant la latence mesurée juste avant :
L = λ × W = 4 000 × 0,138 ≈ 550 threads
Pour avoir de la marge, on monte à 700 threads. Le pool Hikari ne change pas :
server.tomcat.threads.max=700
spring.datasource.hikari.maximum-pool-size=10 # identique
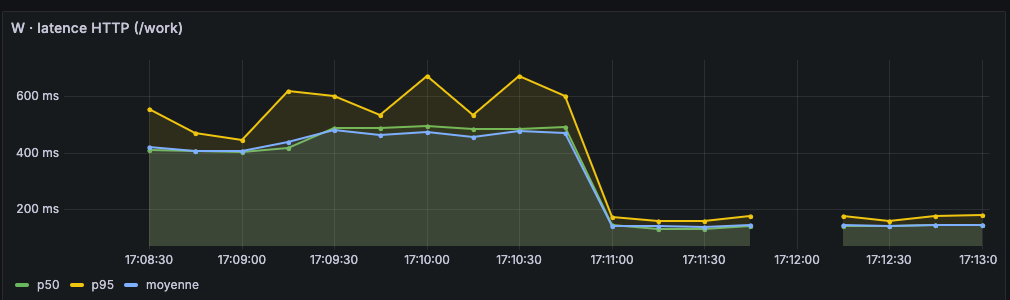
Le résultat est l’inverse de ce qu’on attendait :
- les threads Tomcat sont toujours tous occupés ;
- la latence passe de 140 ms à environ 470 ms.
Sur le graphique, la latence redescend vers 140 ms à 17:11, quand on repasse à 200 threads.
Pourquoi ça ne marche pas ? Link to heading
Le goulot d’étranglement est toujours Hikari. Avec 700 threads, Tomcat accepte plus de requêtes en même temps. Mais le pool Hikari laisse toujours passer le même nombre de requêtes par seconde.
Le débit ne bouge pas. Hikari a toujours 10 connexions, et chacune est occupée environ 7 ms :
λ_max Hikari = 10 / 0,007 ≈ 1 450 req/s
Avec 200 ou 700 threads, l’application traite au plus 1 450 req/s environ. On en demande 4 000, mais le débit réel reste bloqué.
L’erreur de calcul. Le calcul 4 000 × 0,138 contient deux erreurs :
- λ ne vaut pas 4 000 req/s. C’est le débit demandé, pas le débit traité. Le débit traité est de 1 450 req/s ;
- W n’est pas fixe. Les 138 ms comprenaient déjà 28 ms d’attente d’une connexion. Si la file devant Hikari s’allonge, W augmente aussi.
La loi de Little donne la nouvelle latence. Les 700 threads sont occupés, et λ est bloqué à 1 450 req/s :
W = L / λ = 700 / 1 450 ≈ 0,48 s
C’est bien les 470 ms que l’on mesure.
La file a seulement changé de place.
- Avec 200 threads, les requêtes en trop attendaient avant d’entrer dans Tomcat. Cette attente n’apparaît pas dans la latence HTTP mesurée par Spring. Côté client, elle peut finir en timeout.
- Avec 700 threads, ces requêtes entrent dans Tomcat, puis attendent une connexion Hikari. Leur attente compte maintenant dans W.
Ajouter des threads n’a donc rien réglé. On a seulement rendu la file d’attente visible, et payé plus de mémoire pour la stocker.
La bonne correction Link to heading
Il faut agrandir la ressource qui bloque : le pool Hikari.
Une requête SQL occupe une connexion environ 7 ms, et on veut traiter 4 000 req/s. D’après la loi de Little :
L = 4 000 × 0,007 = 28 connexions
Mais il ne faut pas oublier Tomcat. Une fois Hikari corrigé, il n’y a plus d’attente, et W redescend vers 108 ms. Tomcat devient alors le prochain goulot :
λ_max Tomcat = 200 / 0,108 ≈ 1 850 req/s
C’est encore trop peu pour 4 000 req/s. Il faut donc aussi :
L = 4 000 × 0,108 ≈ 430 threads
D’où la configuration :
server.tomcat.threads.max=450
spring.datasource.hikari.maximum-pool-size=30
Ouverture : peut-on augmenter les pools à l’infini ? Link to heading
La loi de Little nous dit combien de threads et de connexions il faut. Alors pourquoi ne pas mettre 10 000 threads et 1 000 connexions, pour être tranquille ?
Parce que chaque thread et chaque connexion coûte des ressources. Et la machine a des limites.
Côté Tomcat Link to heading
- La mémoire. Chaque thread Java réserve sa propre pile, 1 Mo par défaut. 1 000 threads, c’est environ 1 Go réservé.
- Le CPU. Un cœur n’exécute qu’un thread à la fois. Avec beaucoup plus de threads que de cœurs, le système passe son temps à basculer de l’un à l’autre. Ce travail ne sert à rien, et la latence augmente.
Beaucoup de threads, c’est utile quand ils attendent (la base de données, un appel HTTP). Ça ne sert à rien quand ils calculent.
Côté Hikari et base de données Link to heading
Une connexion ouverte coûte aussi des ressources à la base : de la mémoire, et souvent un processus dédié.
Surtout, la base a un nombre limité de cœurs et de disques. Si 100 connexions arrivent en même temps sur une base à 8 cœurs, les requêtes se partagent le CPU. Chacune devient plus lente, et x augmente.
Reprenons la loi de Little :
λ_max = L / x
Si on double le nombre de connexions mais que x double aussi, le débit ne bouge pas. On a juste déplacé la file d’attente dans la base de données.
Enfin, la base a souvent une limite globale. Par exemple, PostgreSQL accepte 100 connexions par défaut (max_connections). Cette limite est partagée entre toutes les instances de l’application.
Que faire quand la machine ne suit plus ? Link to heading
Si le L calculé dépasse ce que la machine supporte, il reste deux leviers :
- réduire W : optimiser les requêtes SQL, ajouter un cache, supprimer un appel inutile ;
- répartir λ : ajouter des instances de l’application derrière un load balancer, ou des réplicas de lecture pour la base.
La loi de Little dit combien il en faut. Le hardware dit combien on peut en avoir.
Conclusion Link to heading
Les métriques exposées par Spring Boot suffisent pour appliquer la loi de Little en production :
- λ et W viennent de
http_server_requests_seconds; - x vient de
hikaricp_connections_usage_seconds; - L se mesure directement avec
tomcat_threads_busy_threadsethikaricp_connections_active.
Avec ces valeurs, on calcule le débit maximal de chaque pool. On sait alors quelle ressource cédera en premier, et à quel débit.